

【衛生福利部《2026 AI影響性研究中心國際研討會》系列文章2】
Yu Shyr PhD
Vanderbilt University Medical Center 生物統計學系主任(Chair)
Vanderbilt Center for Quantitative Sciences 主任
Harold L. Moses 癌症研究講座教授(演講者)
次世代數位醫療平台專案辦公室整理
人工智慧(AI)快速進入醫療場域,如何判斷一套AI工具真正具有臨床價值,已成為醫療機構與研究人員必須面對的重要課題。單純追求漂亮的模型效能指標並不足夠,更重要的是透過外部驗證、真實世界資料及適切的臨床試驗設計,確認AI實際導入醫療現場後,是否能改善臨床決策與病人照護。
AI獲得核准之後,更重要的是回答「臨床上真的有用嗎?」
隨著AI與機器學習廣泛應用於心臟學、腫瘤學等醫療領域,相關醫療器材及演算法持續增加。然而,取得監管機關授權或核准,並不等同於已證明產品在所有真實世界環境中都能產生相同的臨床價值。
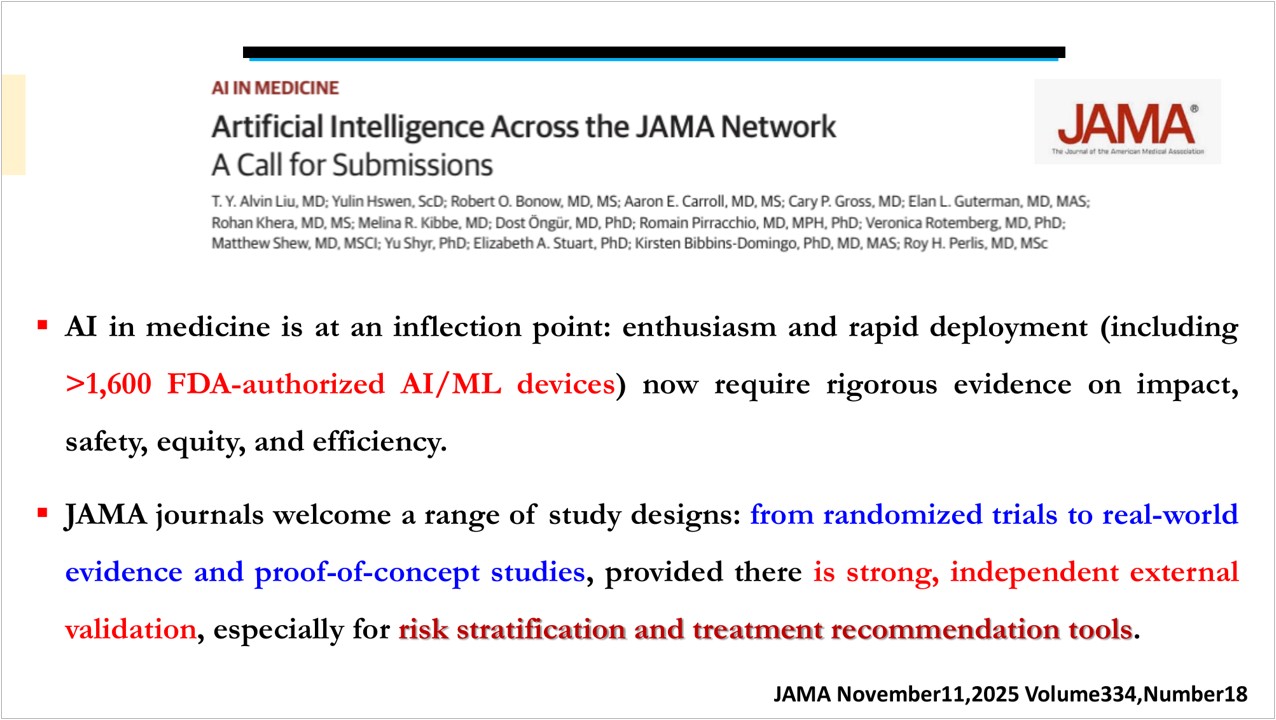
圖一、AI醫療器材快速增加:美國FDA已授權逾1,600項AI/ML器材,需要針對影響力、安全性、公平性與效率提出嚴謹證據
醫療AI的研究不能只停留在模型開發階段,而應進一步取得真實世界資料並進行獨立外部驗證。即使某項AI工具在美國具有良好表現,移至臺灣的醫療環境後,也未必能獲得相同結果,因此不同地區、醫療體系及實際使用情境下的驗證十分重要。
換言之,評估醫療AI時真正需要回答的問題,不只是「演算法準不準」,更包括它在目標臨床環境是否可靠、安全、可行,以及最終能否改善決策品質與臨床結果。
從單次試驗走向「務實型平台試驗」
面對AI產品快速迭代的特性,傳統固定式臨床試驗未必能完全因應。演講因此提出「務實型平台式臨床試驗」的概念,將AI工具直接置於實際醫療流程中進行比較。
以低劑量電腦斷層肺癌篩檢為例,可同時設置標準照護及不同AI介入組,並在試驗進行期間安排中期分析。若某一項AI演算法的表現不理想,可以停止該介入,並引進新的AI工具進入平台持續評估;表現符合要求的演算法則可繼續進行後續比較。
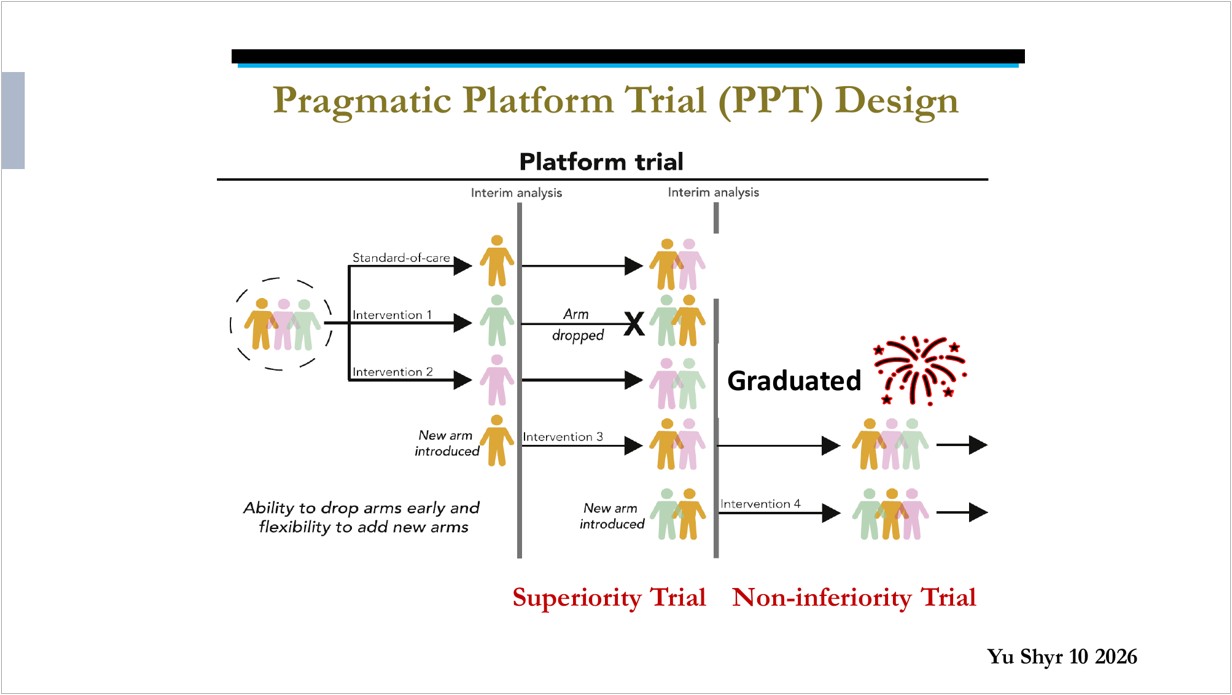
圖二、務實型平台試驗(Pragmatic Platform Trial, PPT)設計示意圖
這樣的設計使醫療體系不必等待所有候選工具完成一套固定且漫長的試驗後,才決定下一步,而能根據階段性資料動態調整研究內容。對快速發展的AI產品而言,也提供一種更貼近臨床現場的評估模式。
演講亦提醒,這類研究並非適用於所有情境。研究設計仍必須考量介入本身是否具有額外風險,以及倫理審查和病人同意等要求,不能單純因為採用務實型試驗,就推論所有研究皆可免除相關程序。
AUC很高,就代表AI具有臨床價值嗎?
除了重新思考臨床試驗設計,演講另一項核心問題,是如何解讀AI的效能指標。
過往AI研究經常透過ROC曲線下面積(AUC)衡量模型的鑑別能力。一個AUC達到0.95甚至更高的模型,直觀上可能令人認為表現十分優異,但從臨床角度來看,單一數值未必足以反映模型真正帶來的價值。
演講以使用游離DNA進行染色體三體症篩檢的研究為例說明。傳統篩檢與游離DNA檢測若僅比較AUC,都可能呈現看似出色的數值;然而進一步檢視陽性預測值(PPV)等指標,就能看到截然不同的臨床意義。
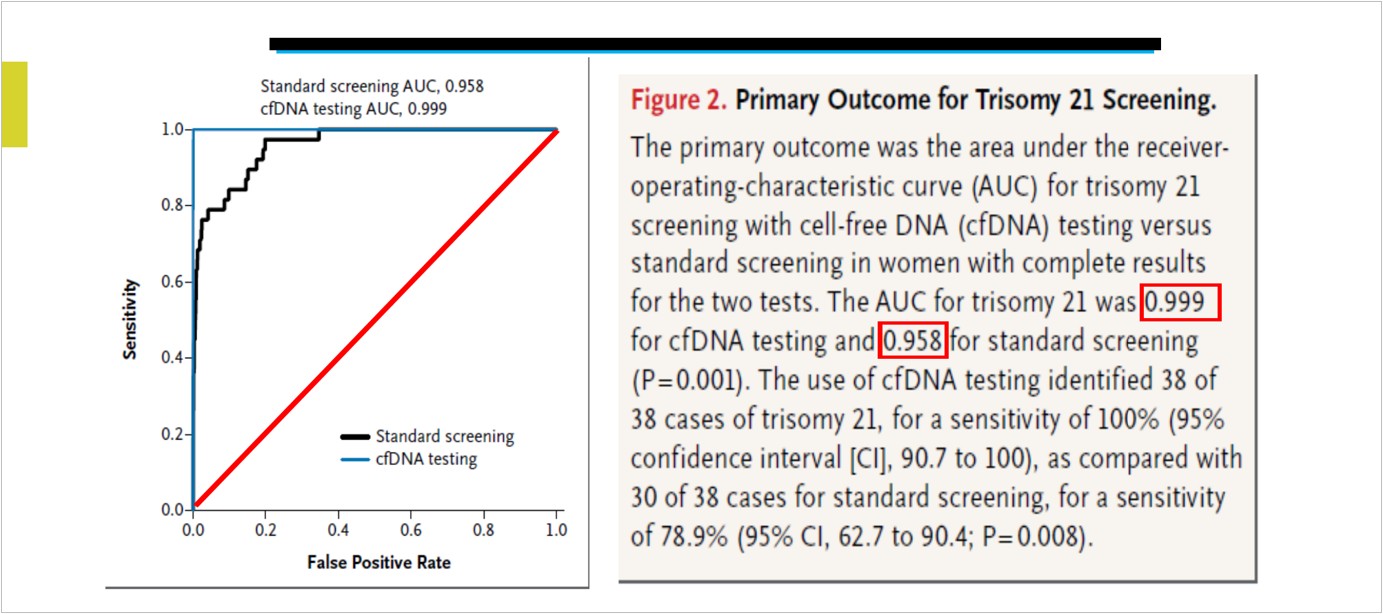
圖三、游離DNA(cfDNA)檢測與傳統篩檢之ROC曲線比較:AUC分別為0.999與0.958。
傳統篩檢結果為陽性的884人中,實際僅30例為真正陽性,PPV約為3.4%。也就是說,如果只看到「AUC很高」便認定檢測具有出色的臨床表現,就可能忽略大量偽陽性所造成的實際影響。
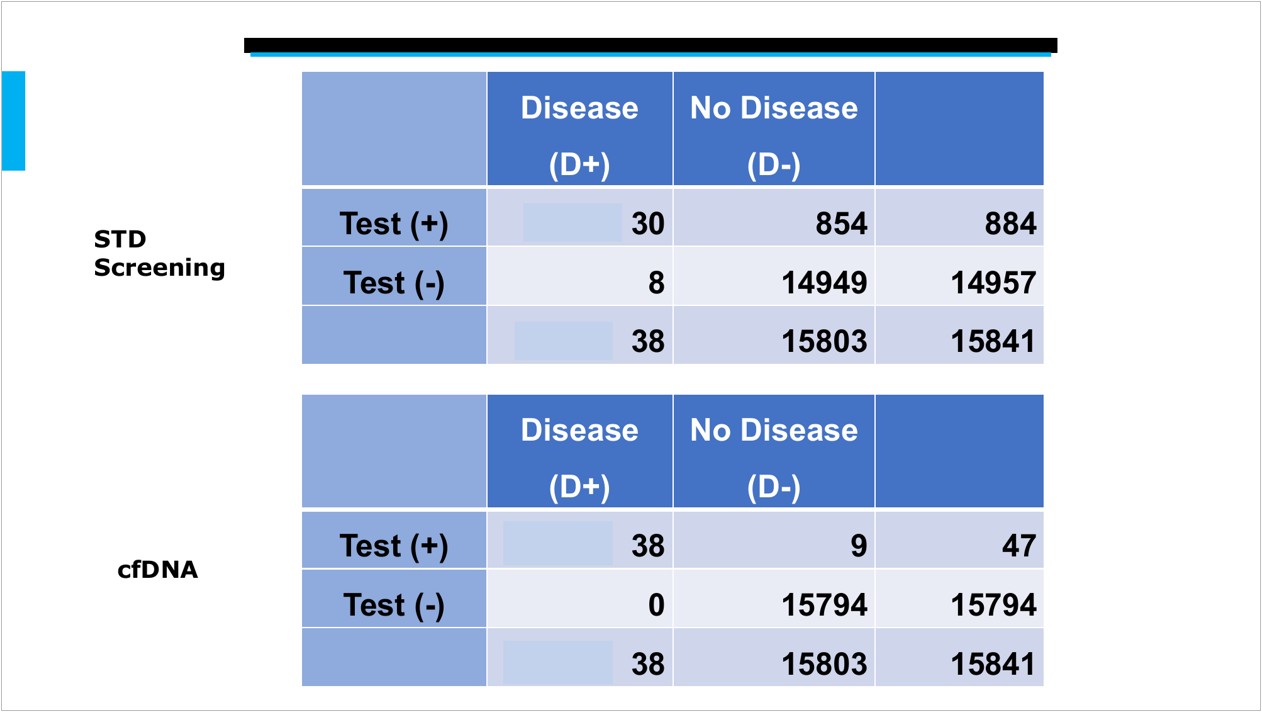
圖四、傳統篩檢與cfDNA檢測之結果對照圖
這也突顯醫療AI評估的一項關鍵原則:統計表現良好,不必然等同於臨床效益良好。
從ROC、PPV到F1 Score,讓統計指標回答臨床問題。因此,評估AI時不能只依賴單一指標,而應同時思考敏感度、陽性預測值,以及綜合精確率與召回率概念的F1 Score等資訊。
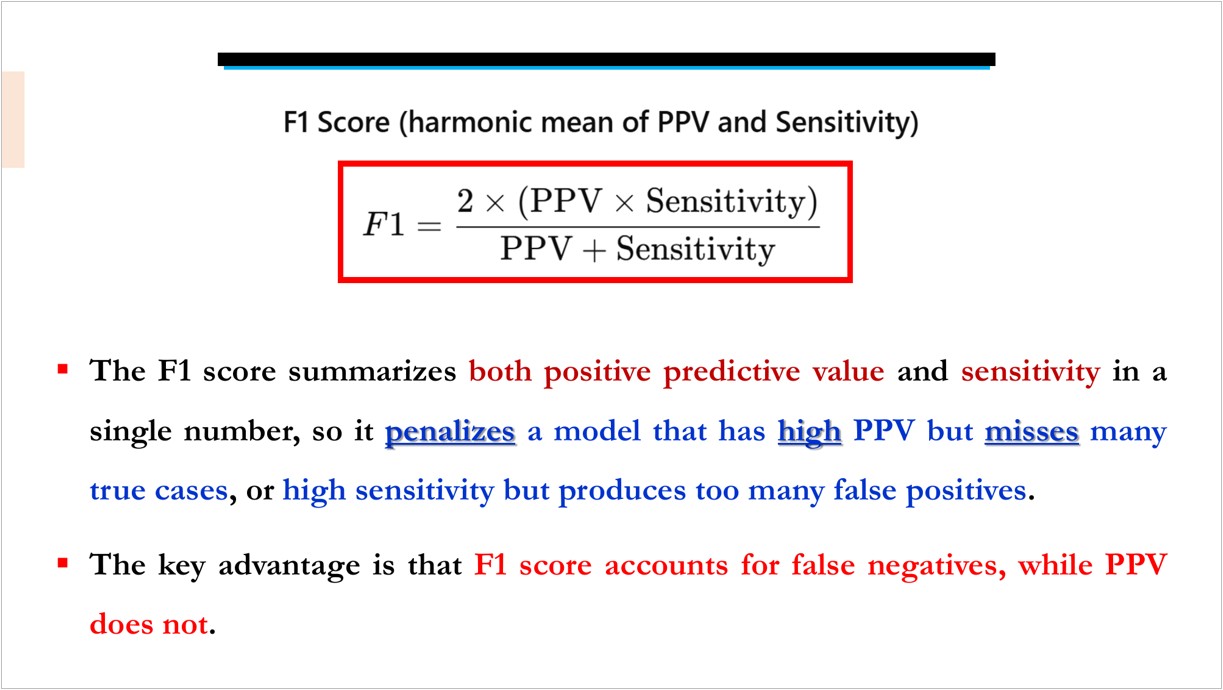
圖五、F1 Score為陽性預測值(PPV)與敏感度的調和平均數,可同時反映偽陽性與偽陰性的影響。
前述案例中,不同檢測方式若改以F1 Score觀察,差異便比單看AUC更加明顯。這代表選擇評估指標時,應由具體的臨床問題出發,而非只追求一個容易比較、看似漂亮的模型數字。
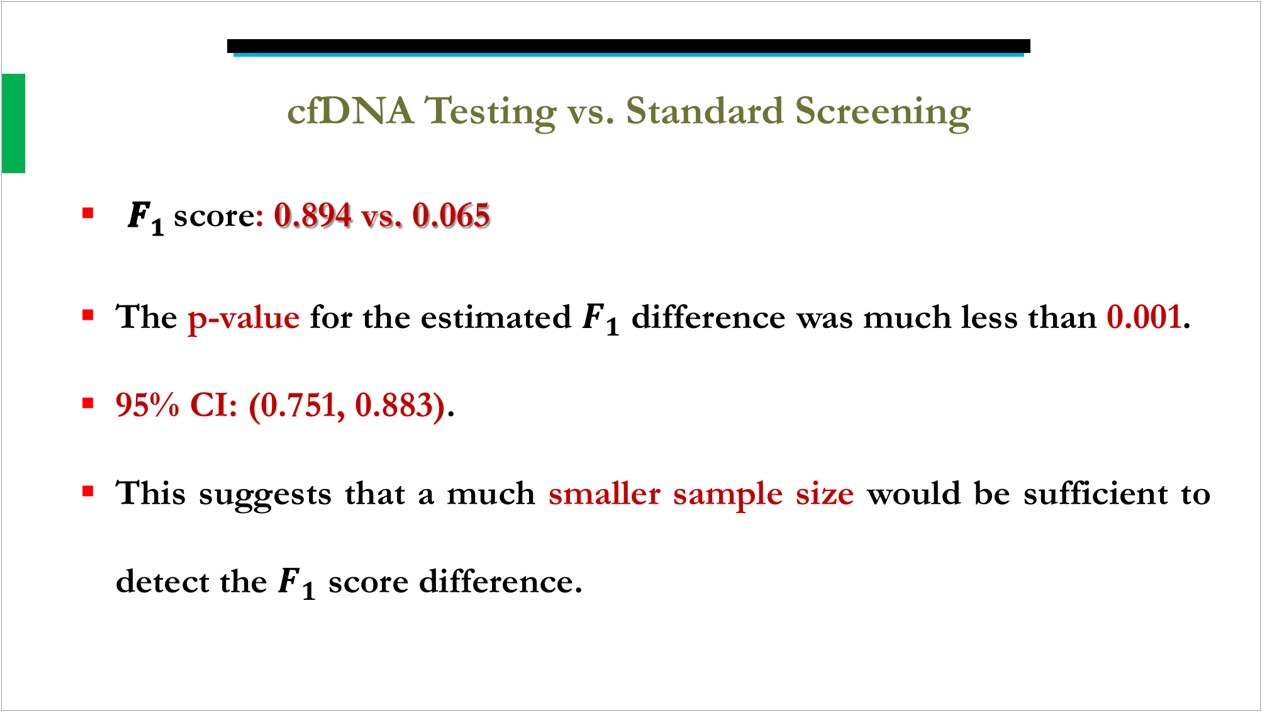
圖六、cfDNA檢測與傳統篩檢之F1 Score比較:0.894 對 0.065(p值遠小於0.001)。
對醫療AI開發者而言,這項觀念尤其重要。演算法最終面對的是實際病人與醫療決策,因此研究設計需要把統計效能和臨床後果連結起來,才能回答AI是否真正值得導入。
從「平均治療效果」邁向個人化效益
傳統臨床研究經常關注平均治療效果(Average Treatment Effect, ATE),但平均值可能掩蓋不同病人之間的重要差異。同一項介入不一定讓所有人獲得相同程度的效益,因此AI與機器學習的重要應用之一,就是進一步找出「哪一種治療對哪一類病人更適合」。
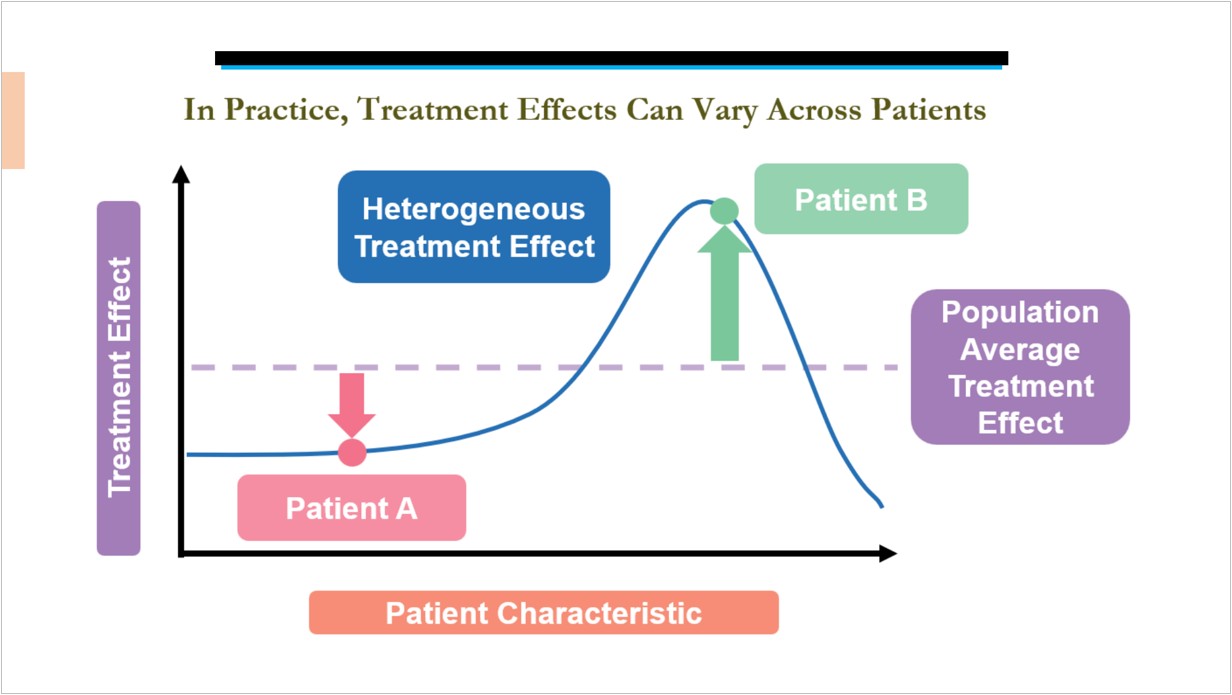
圖七、實務上治療效果會因病人而異:個別病人的效益可能高於或低於族群平均治療效果。
以急診病人的氧氣治療為例,說明不同病人可能適合不同的血氧目標。研究透過機器學習方法,把病人的個人化特徵加入模型,嘗試判斷個別患者相較於標準治療,採取不同治療策略可能增加多少效益。
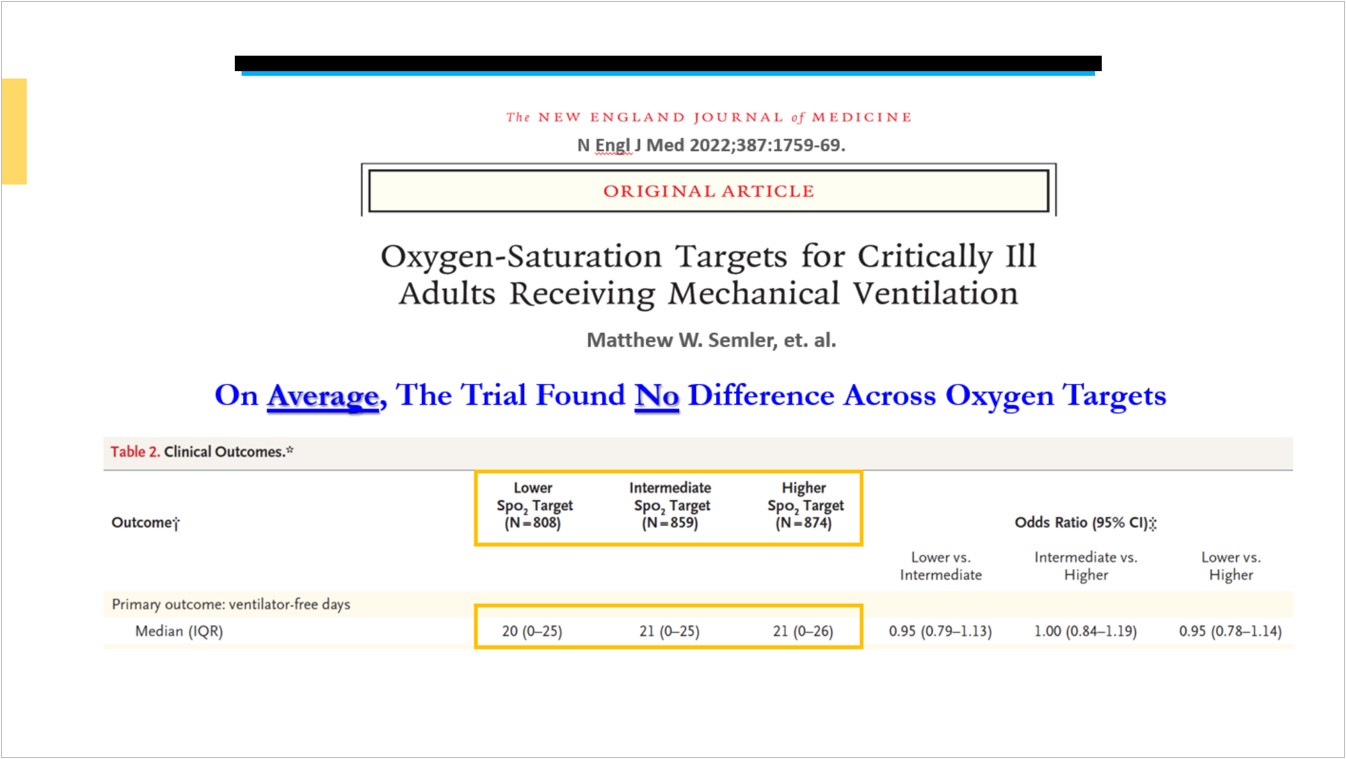
圖八、氧氣目標試驗的平均結果
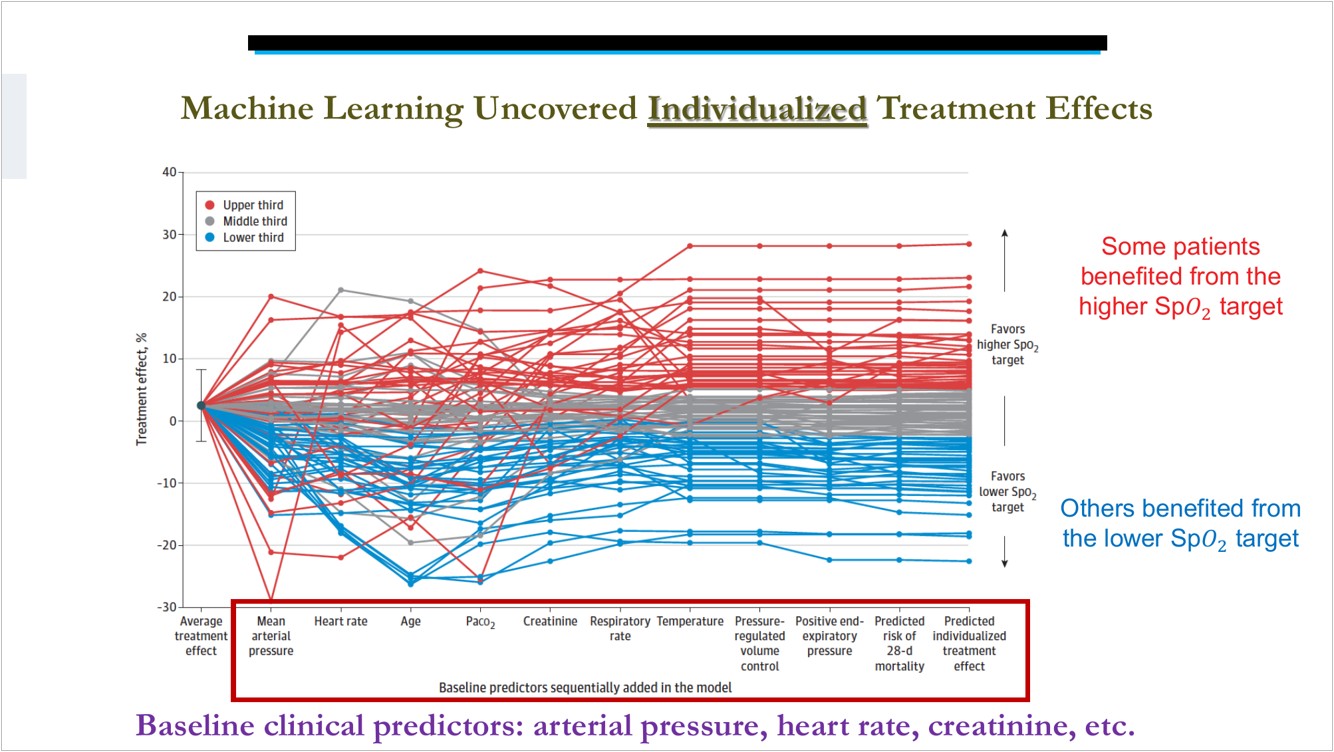
圖九、機器學習揭示個人化治療效果:部分病人較適合較高的血氧目標,另一些病人則較適合較低的血氧目標。
這樣的思維也使AI的角色產生轉變。AI不再只是回答「某種治療平均而言是否有效」,而是進一步協助臨床人員評估,眼前這一名患者可能更適合何種策略。
AI導入醫療現場,真正的考驗在真實世界
在研究成果進一步部署至電子健康紀錄(EHR)及臨床系統後,醫師可以在照護現場取得模型提供的資訊,再結合專業判斷作出決策。如此一來,研究者才有機會觀察AI建議是否真正被使用,以及導入AI後究竟能否形成實質的臨床效益。
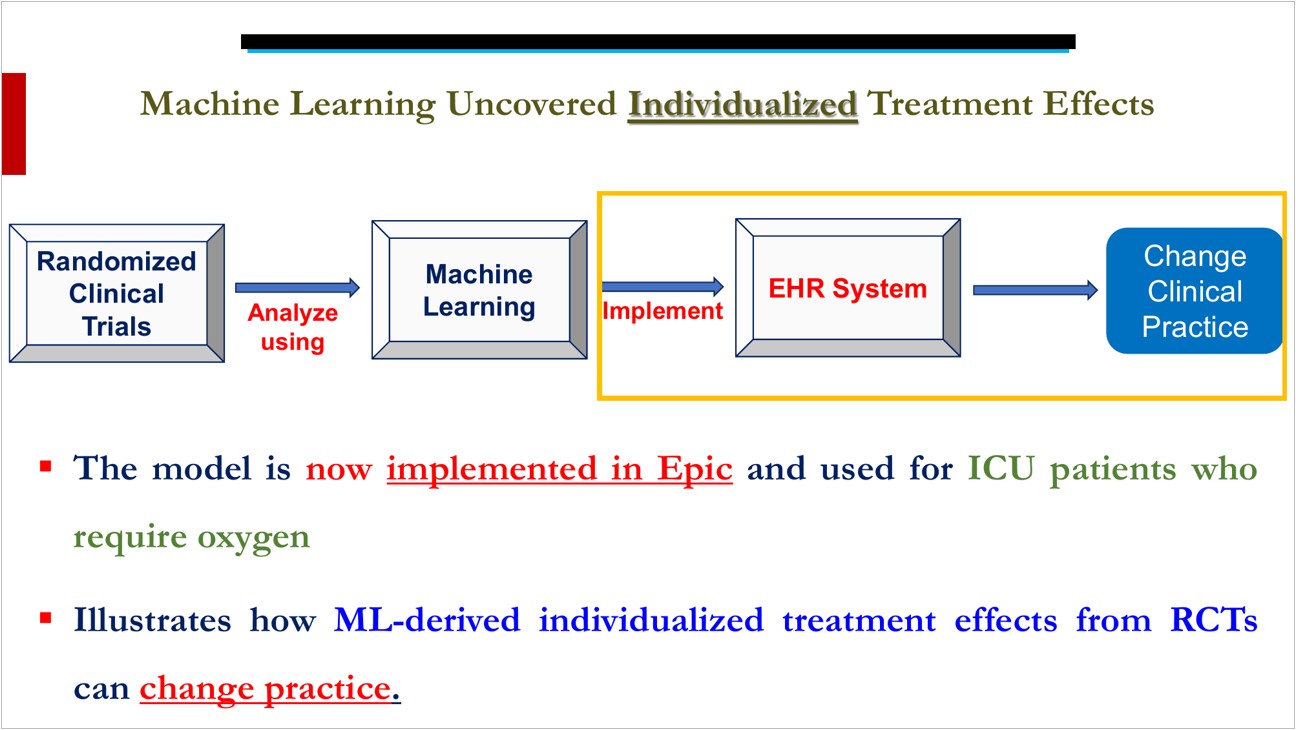
圖十、將隨機臨床試驗結果以機器學習分析,並部署於電子病歷(EHR)系統以改變臨床實務;該模型現已導入Epic,用於需要氧氣的ICU病人。
這也呈現出醫療AI研究從「模型」走向「臨床」所必須經歷的完整路徑:從演算法開發與外部驗證,到真實世界測試、適合的統計評估,再到醫療工作流程中的實際部署,每一個階段都是驗證AI價值的重要環節。
讓醫療AI從「高準確率」真正走向「高臨床價值」
醫療AI的下一階段,重點不只是持續打造更高AUC、更高準確率的演算法,而是建立一套能回答臨床問題的驗證方法。
從獨立外部驗證、真實世界資料,到適應性與務實型平台試驗;從重新檢視AUC、PPV及F1 Score,到進一步探索個人化治療效益,本場演講凸顯了一個核心方向:AI的價值不能只存在統計模型裡,而必須回到實際的臨床決策與病人照護中接受驗證。
唯有讓研究設計、統計方法、倫理規範與臨床需求彼此銜接,醫療AI才能從「技術上可行」,進一步走向「臨床上真正有用」。