

【衛生福利部《2026臨床 AI 取證驗證中心國際研討會》系列文章4】
Long Phi Le, MD, PhD
Associate Director , MGB AI Institute
麻州總醫院 MGB AI 研究所副主任(演講者)
次世代數位醫療平台專案辦公室整理
生成式 AI 在真實醫療場域落地面臨的關鍵問題
下午第三位講者是哈佛醫學院與麻州總醫院體系(MGB)AI 研究所副主任李龍飛教授。他長年深耕病理資訊學與臨床 AI 基礎模型研究,同時也是多家新創公司的共同創辦人,當天演講的核心聚焦於如何打造「主權就緒」(Sovereign-ready)的多模態醫療基礎模型——也就是備受矚目的 Apollo 專案。
李龍飛首先指出,當前生成式 AI 在真實醫療場域的落地應用面臨四大關鍵問題:
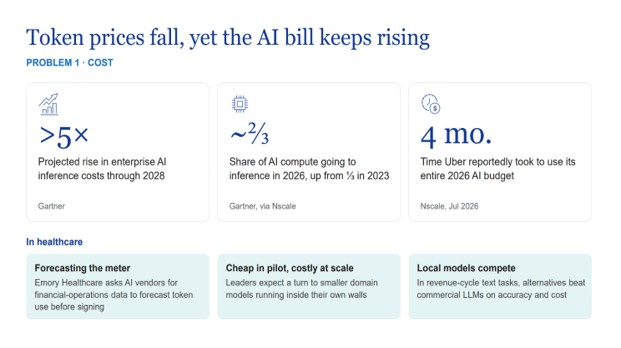
1.推論成本(Cost):預估到 2028 年,企業 AI 的推論成本將暴增 5 倍以上,推論占整體 GPU 運算的比例也已從 2023 年的三分之一攀升至 2026 年的三分之二。他以 Uber 全年代理人推論預算在短短四個月內燒光為例,提醒醫療院所若將試辦規模擴大到兩、三萬名醫師全面使用,其 token 費用將極為驚人;相對地,開源小模型在本地執行時,無論在成本或準確度上都已展現強大競爭力。
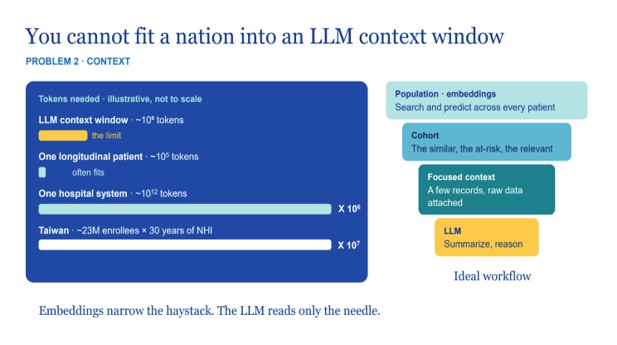
2.脈絡長度(Context):單一病人的完整縱向病歷約需 10 萬個 token,勉強可塞進百萬 token 的大型語言模型(LLM)脈絡視窗中;然而,若要將整間醫院約 10 的 12 次方規模,或是臺灣 2,300 萬人口、長達 30 年的健保資料全部塞進單一提示詞,在物理與運算上根本不可能實現。
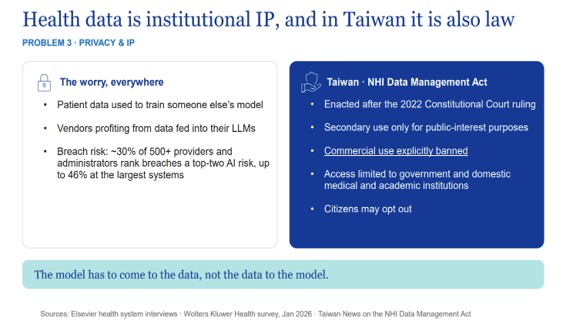
3.隱私與智慧財產權(Privacy & IP):沒有任何一間醫院願意將敏感的病人資料外傳或拿去幫外部廠商訓練模型。因此,最正確的架構思維不是「把資料帶到模型」,而是「把模型帶到資料身邊」。此外,在臺灣,《全民健康保健醫療資料管理條例》也明確規範次級利用僅限於公共利益目的,商業使用受到嚴格限制,資料必須留在國內與機構防火牆之內。
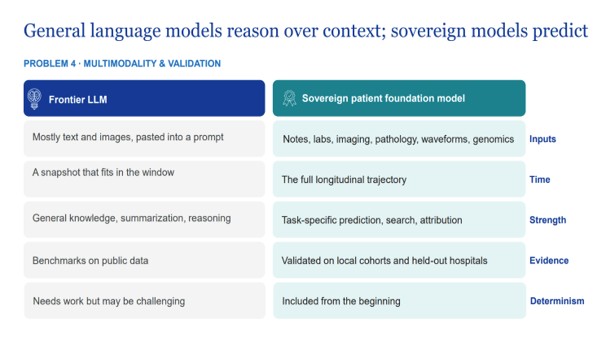
4.多模態、縱向與確定性(Multimodality & Validation):臨床預測需要跨越檢驗、文字、病理與放射影像、波形及基因體等多元資料。通用大模型缺乏這類深度訓練資料,且只看單次對話快照,推論結果更缺乏確定性(同樣輸入可能得到不同結果)。
  |
  |
從單一任務邁向全病人維度的 Apollo 模型
臺灣目前雖已核准超過 50 個 AI 醫療產品,但多半屬於針對單一任務、手工設計特徵的監督式學習模型。因此,李龍飛主張應改以領域基礎模型(Domain Foundation Model)為起點:原始資料只要透過模型嵌入(Embedding)一次,同一個嵌入向量就能重複支援成千上萬個下游預測任務,並能直接用於族群搜尋與相似病人檢索。
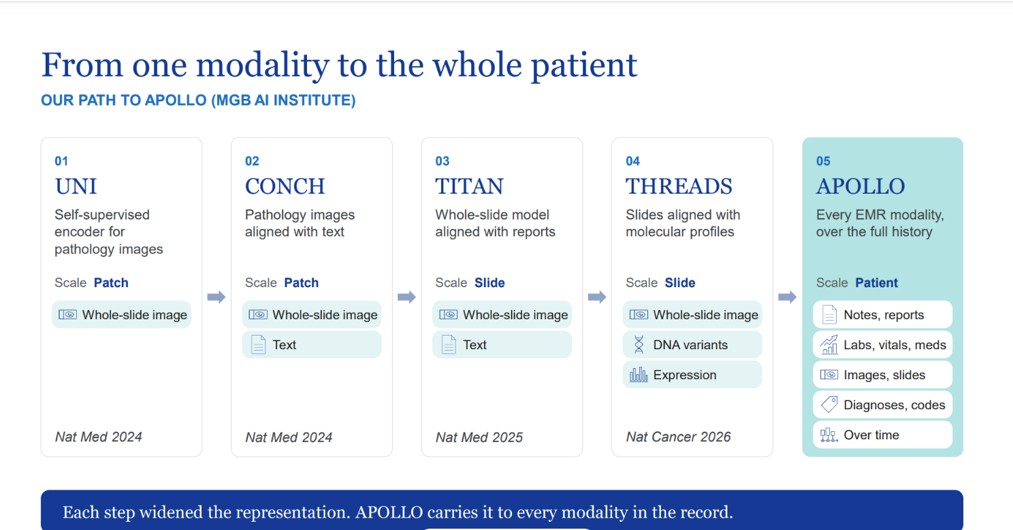
這正是 MGB AI 研究所發展 Apollo 的設計核心。回顧他們的發展路徑,從早期專注病理切片的 UNI、圖文對齊的 CONCH 與 TITAN,到結合分子特徵的 THREADS,最終演進到涵蓋 EMR 所有模態的 Apollo:
- 模型規模與訓練架構:Apollo 採用超過 70 億筆醫療事件進行訓練,將診斷與藥物視同文字、保留檢驗值的精確數值、文字與影像透過預訓練編碼器進行壓縮,並在每個 token 附加病人年齡作為時間標記。
- 預測與可解釋性:透過因果式 Transformer(Causal Transformer)學習預測病人的未來,最終以一個摘要 token 的隱藏狀態作為「病人嵌入向量」(Patient embedding),並在 314 項醫療結局(Endpoints)上完成驗證;透過逐一移除歷史事件重新計算,還能清晰看出究竟是哪幾筆臨床紀錄推高了特定風險。
臺灣導入主權級基礎模型的「三種路徑」
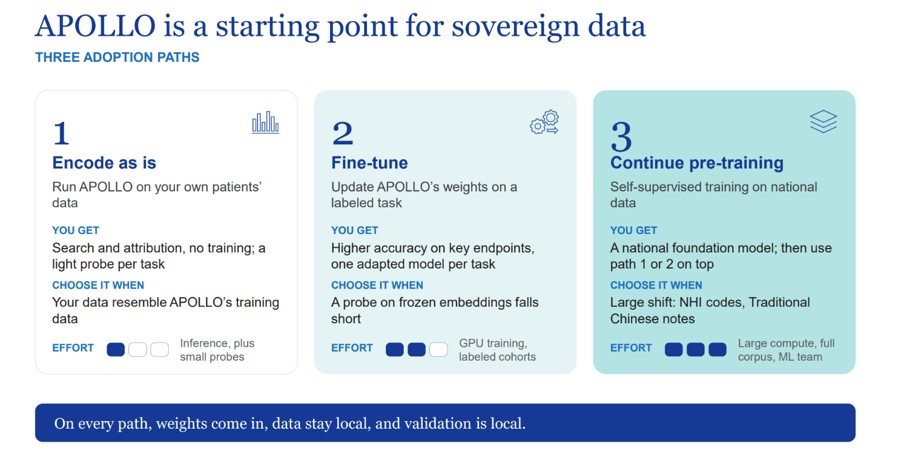
針對臺灣的實際導入與應用,李龍飛提出了三種具體可行的實作路徑:
- 直接取用嵌入向量(Encode as is):直接運用 768 維的凍結嵌入向量,搭配簡單的線性探針(Linear probe)來執行搜尋、屬性歸因與特定預測,完全不需重新訓練。
- 針對特定任務微調(Fine-tune):在標記任務上更新 Apollo 的權重,以在關鍵預測指標上獲得更高準確度。
- 全國規模持續預訓練(Continue pre-training):以國內 2,300 萬人口的龐大資料庫進行自我監督式持續預訓練,打造出真正屬於臺灣的「國家級醫療基礎模型」。
在實作架構上,系統會將每位病人每次就診的資料嵌入一次並存入向量資料庫,讓原始資料與嵌入向量並存;當醫師在臨床點擊介日時,就能立即溯源並看見是哪一份病歷或影像促成了該項預測。藉由「嵌入向量先縮小搜尋範圍、大型語言模型只讀取精準片段(Retrieve first, reason last)」的流程,不僅能大幅降低推理成本,也讓主權級 AI 變得切實可行。
實現醫療 AI 主權的條件盤點與結論
在推動主權級醫療 AI 的條件盤點中,李龍飛認為臺灣在運算力基建、FHIR 與醫療代碼標準化、隱私法規以及豐富的在地資料上都已經完全到位;而未來尚待克服或決定的挑戰,則包含在地推理模型的成本控制、確保廠商中立性以避免遭特定技術鎖定、開源模型與隔離環境的部署策略,以及專業跨域人才的培育。
他在結語中強調,主權級醫療 AI 已經是觸手可及的目標:醫療體系應建立在專屬的醫療基礎模型之上,打造「醫療記憶系統」實現「嵌入一次,處處複用(Embed once, reuse everywhere)」,並堅持「模型走向資料、資料留在本地、驗證在地完成」的核心原則,讓大型語言模型專注於演繹推理,共同守護病人安全與臨床價值。
在演講尾聲Q&A環節 中,有人問 Apollo 模型成本是否會成為障礙。他回應新版 Apollo 以一張 B300 約一週就能訓練完成, 真正的大工程是資料前處理;相較於逐一對兩千萬名病人下提示,嵌入一次、重複使用更有效率。 而當被問到最大的困難時,他認為在資料與人才就緒之後,挑戰在於乾淨的標記、可信的評估基準與足 夠的保留測試集,以及臨床醫師的認同。至於全國規模是否影響準確度,他認為資料愈多愈好, 臺灣單一支付體系反而有利於差異自行平衡。 關於監管與商業模式,他則強調 Apollo 是確定性的表徵模型,而非聊天機器人,仍須接上乾淨標記與基準來驗證,現有的五十個模型也可以用同一組嵌入重建。商業上,學術版將開源,商用則另行授權,公司端走的是以節省成本、挽救病人為導向的共享模式。最後,流行病學背景的提問者問到問卷與行為因素,他表示問卷可轉為文字嵌入,但 MGB 的資料在 HIV 等議題未必完整,建議微調,或以自有資料繼續預訓練。