【衛生福利部《2026 AI影響性研究中心國際研討會》系列文章3】
Allen Hsiao, MD
Chief Health Information Officer, Yale New Haven Health System ,
Yale School of Medicine
耶魯大學醫學院小兒科、生物醫學資訊與資料科學/急診醫學教授
耶魯大學醫學院與耶魯大學紐哈芬醫療系統首席健康資訊長(演講者)
次世代數位醫療平台專案辦公室整理
人工智慧(AI)快速進入醫療領域,從疾病風險預測、臨床決策支援,到病歷摘要與環境式AI紀錄工具,AI應用正逐步融入日常醫療。然而,一個模型「預測得準」,是否就代表它真的能改善臨床照護?
Allen L. Hsiao教授以AI治理、電子健康紀錄(EHR)、隨機臨床試驗與真實世界證據為主軸,分享AI從模型走向臨床所面臨的關鍵挑戰。他強調,醫療AI真正的價值,不只在於模型能否提供準確預測,更在於預測能不能轉化為實際行動,最終改善臨床照護與病人結果。
AI進入醫療現場,第一步是建立治理機制
當愈來愈多AI工具進入醫療體系,如何決定哪些工具可以使用、應如何驗證,以及部署後由誰負責持續監測,已經成為醫療AI落地不可迴避的問題。
Allen L. Hsiao教授以Yale的經驗指出,AI治理需要涵蓋策略治理、標準化評估與風險管理、多方利害關係人的參與,以及EHR整合與人員教育等不同層次。評估一套AI系統時,也必須同時考量問責、自主、公平、誠信、不傷害、隱私、安全、透明與信任等原則。
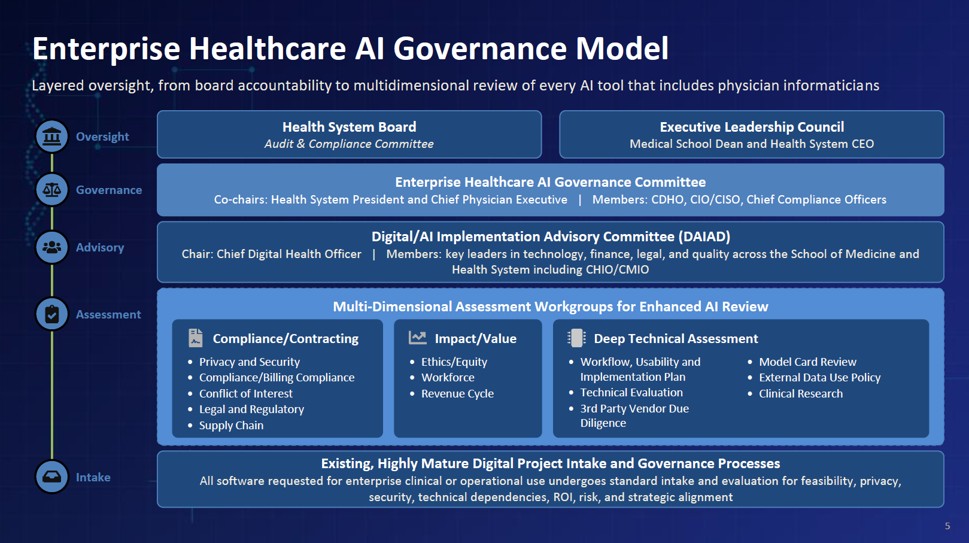
圖一、Enterprise Healthcare AI Governance Model
因此,AI導入並非單純採購一項資訊工具,而是一套跨領域治理工作。從醫療體系管理階層、AI治理委員會,到數位與AI導入諮詢及多面向評估團隊,不同層級共同負責AI的審查與導入,評估範圍則涵蓋隱私、安全、法規、倫理、公平性、工作流程、技術表現及第三方廠商等面向。
其中,「模型卡(Model Card)」扮演重要角色。Allen L. Hsiao教授將模型卡比喻為食品的「營養標示」,協助使用者了解模型用了哪些資料、資料從何而來、模型表現如何,以及有哪些限制。尤其AI模型可能持續更新,模型卡更有助於醫療機構掌握版本變動,並判斷既有驗證結果是否仍然適用。
不是所有AI,都需要相同強度的臨床驗證
醫療AI用途廣泛,不同工具可能帶來的風險也大不相同。因此,Allen L. Hsiao教授提出依據風險決定證據強度的評估思維。
簡報將AI評估概括為五個階段,包括回溯性驗證、靜默模式(Silent Mode)、小規模試點、務實型隨機對照試驗或分階段部署,以及上線後的持續監測。對環境式AI紀錄、訊息草稿等較低風險工具,可著重前三階段並搭配監測;涉及敗血症、病情惡化或診斷等較高風險應用,則應接受更完整的五階段評估。
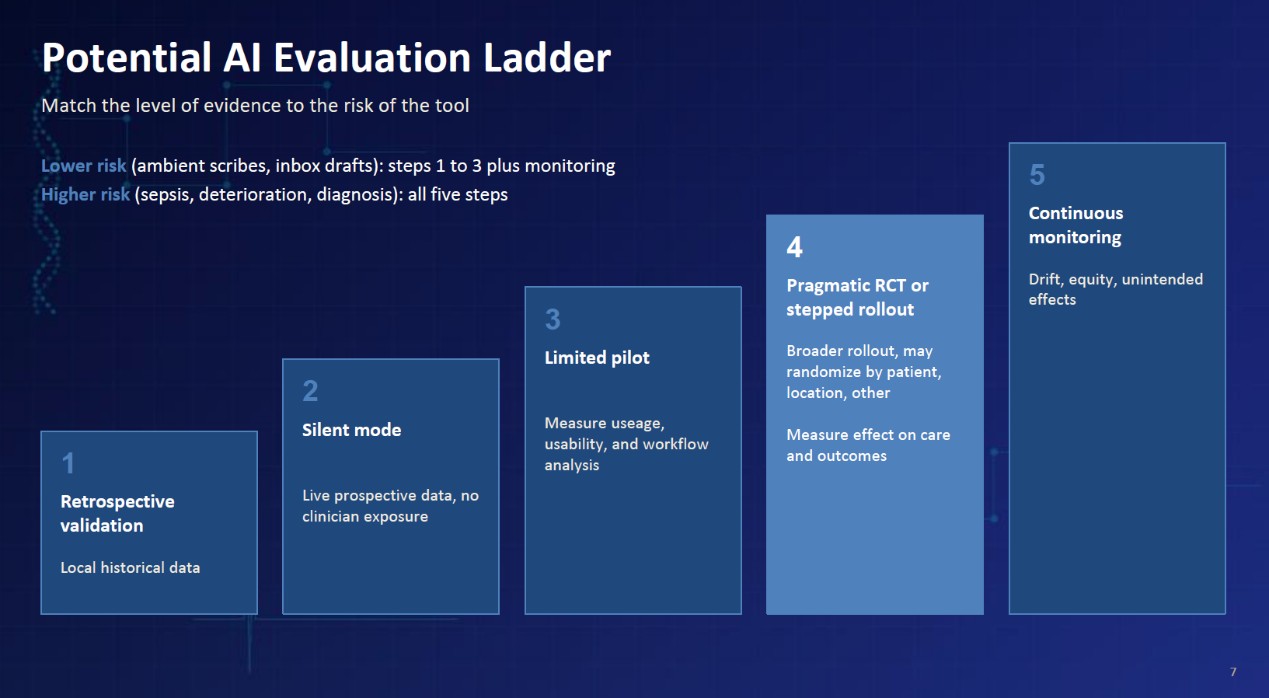
圖二、Potential AI Evaluation Ladder
風險判斷的重要分界之一,是AI是否會在缺乏醫師監督的情況下採取行動。如果AI直接影響高風險醫療決策,就需要更加嚴謹的研究設計;若只是協助草擬文字等低風險工作,則未必都需要進行隨機對照試驗。
準確率高,不等於真正改善病人結果
醫療AI臨床應用最重要的一項課題,是不能將「模型準確」直接等同於「臨床有效」。
圖三為針對Epic敗血症預測模型的外部驗證研究。該研究涵蓋27,697名患者、38,455次住院紀錄,模型外部驗證的AUC僅0.63,67%的敗血症病例未被模型辨識,同時卻有18%的住院病人觸發警示。這個案例顯示,廠商所提供的模型表現未必能直接移植至個別醫療環境,部署前的在地驗證至關重要。
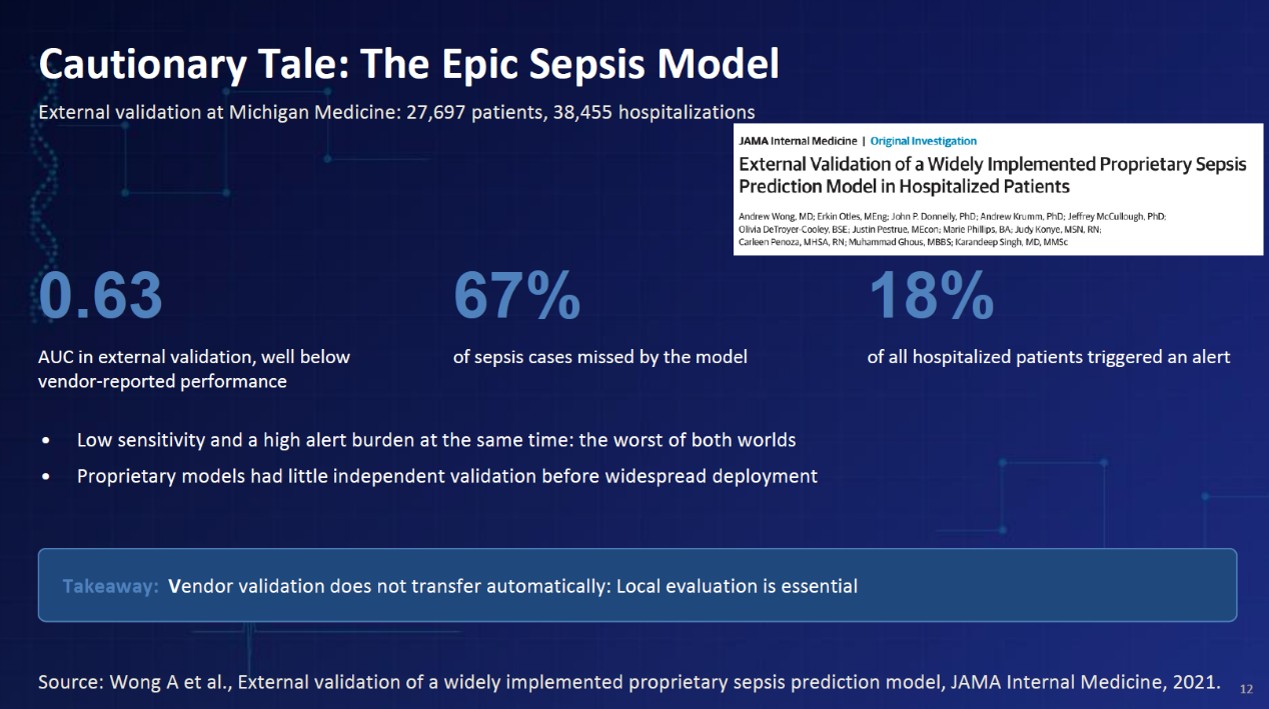
圖三、Cautionary Tale: The Epic Sepsis Model
這也凸顯另一項臨床風險。當AI大量產生警示,卻未能精準辨識真正需要介入的病人時,可能增加第一線醫療人員的警示負擔。因此,AI評估不應停留在模型效能,更需要觀察實際部署後的工作流程與臨床結果。
把電子病歷變成AI的臨床試驗平台
如何確認AI是否真的有效?Allen L. Hsiao教授提出一個重要方向,也就是將EHR本身轉化為臨床試驗平台。從即時辨識符合條件的病人、將患者或臨床單位隨機分組、在工作流程中提供AI介入,到直接利用EHR資料取得研究結果,最後根據結果調整與擴大部署,一系列過程都可以整合至數位醫療環境中。
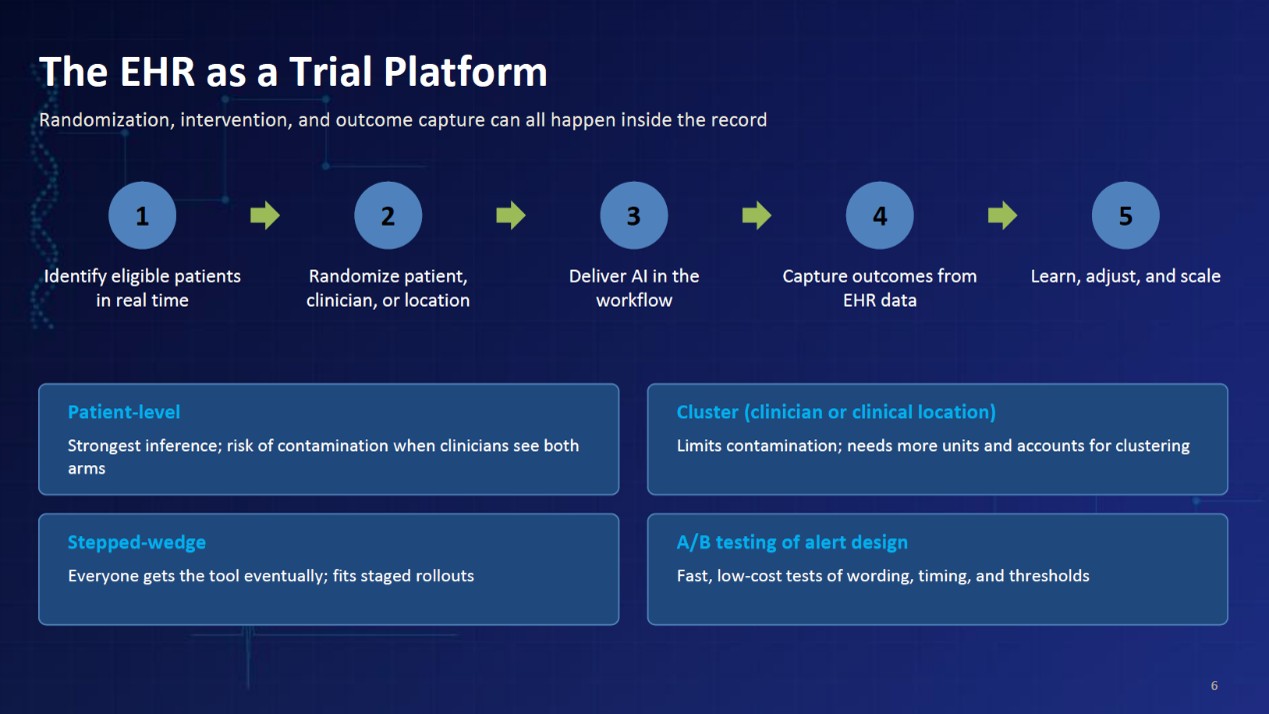
圖四、The EHR as a Trial Platform
研究設計也不只有傳統的個人層級隨機化。例如,集群隨機分派(Cluster Randomization)可降低同一位醫師接觸不同組別後產生的干擾;階梯式設計(Stepped-wedge)則讓不同群組分階段導入工具,使所有參與單位最終都有機會使用新的介入措施。
這些方法讓醫療體系得以在真實工作流程中回答最重要的問題,不只是「AI能不能預測」,而是「導入AI之後,醫療照護實際發生了什麼改變?」
多一個警示,不一定帶來更好的結果
Allen L. Hsiao教授特別以急性腎損傷(AKI)的ELAIA-1研究說明隨機試驗的重要性。這項研究在Yale New Haven Health旗下6家醫院納入6,030名患者,透過EHR警示提醒臨床人員病人發生AKI。但研究結果顯示,一項原本看似理所當然有幫助的警示,未能帶來預期效益,在部分場域甚至出現值得警惕的結果。
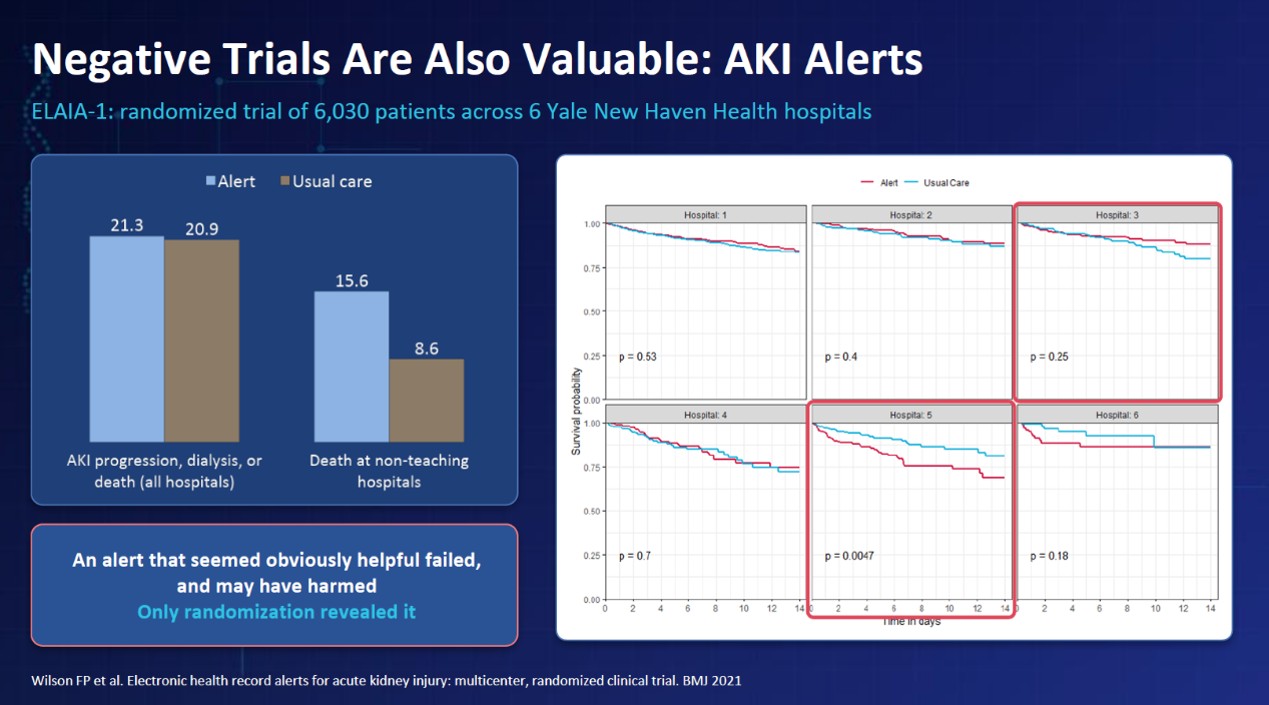
圖五、Negative Trials Are Also Valuable: AKI Alerts
這項研究帶來的啟示,並不是證明所有電子警示「沒有用」,而是顯示相同工具進入不同醫院與工作流程後,可能產生不一樣的效果。唯有透過嚴謹的研究,才有可能辨識這些差異。
也因此,負面結果並不代表研究失敗。Allen L. Hsiao教授強調,沒有達到預期效果的研究同樣值得公開,因為這些結果能讓醫療界重新檢視研究設計,也能避免其他醫療機構重複承擔相同風險。
「知道風險」還不夠,重點是下一步能做什麼
另一個重要案例是心臟衰竭研究REVEAL-HF。研究納入3,124名心臟衰竭住院患者,透過EHR隨機分組。系統將預測得到的一年死亡風險提供給臨床醫師,但結果顯示,單純提供風險資訊並未顯著改變照護決策及相關臨床結果。
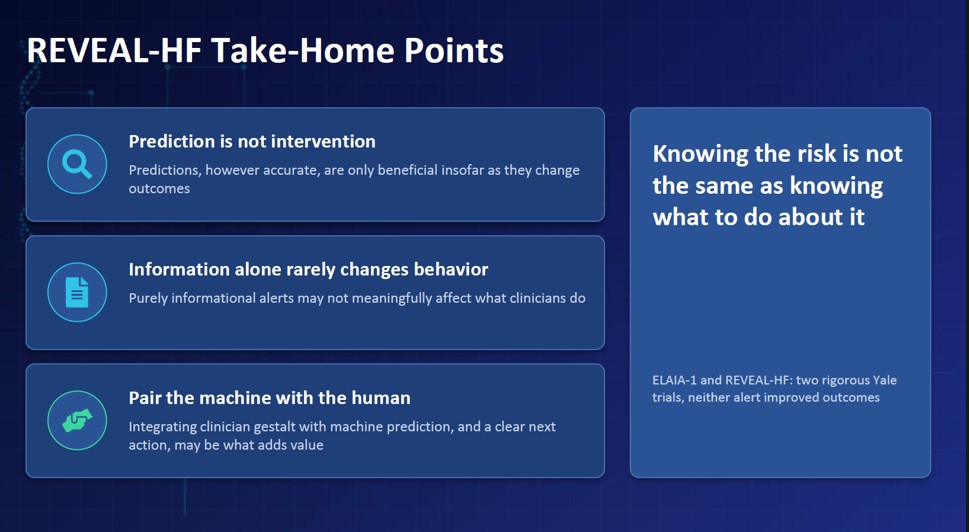
圖六、REVEAL-HF Take-Home Points
這個案例提出一個非常關鍵的觀念:
Prediction is not intervention。預測本身並不是介入。
即使模型成功告訴醫師「這名病人的風險很高」,如果沒有清楚說明接下來可以採取什麼行動,這項資訊仍可能無法改變照護。
演講中的其他務實型試驗進一步凸顯了「可行動性」的重要。簡報所列的EAGLE研究將AI心電圖應用於低射出分率辨識,新診斷比例由一般照護組的1.6%提高至介入組的2.1%;另一項腫瘤照護研究將機器學習死亡風險預測與臨床提示結合,高風險患者的嚴重疾病相關對話由4%提高至15%。共同特點在於,AI不只是呈現預測,而是與明確的臨床工作流程及後續行動相連結。
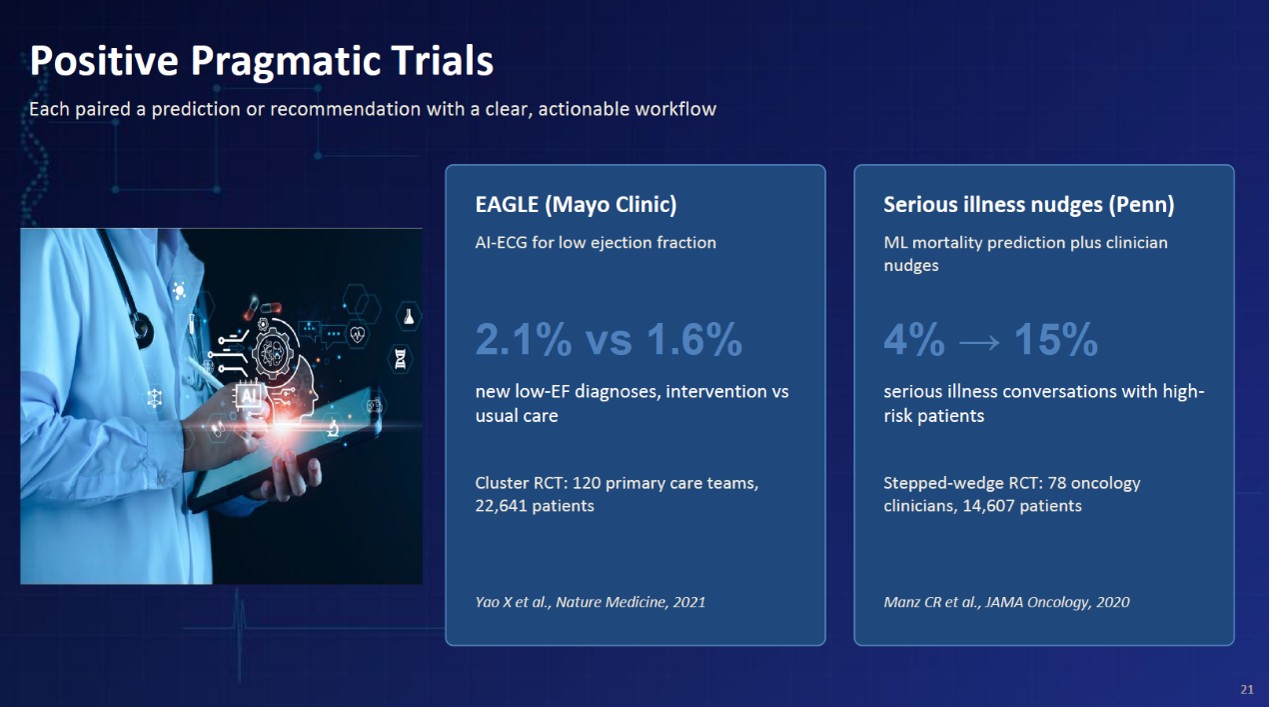
圖七、Positive Pragmatic Trials
這些結果顯示,生成式AI已經開始展現改善醫療人員工作流程的潛力,但提高效率與改善病人結果仍然是兩個不同層次的問題。下一階段的研究,需要更進一步證明這些工具能否帶來真正的臨床效益。
把每一次AI部署,都視為持續學習的開始
醫療AI並不是模型上線後就完成任務。演講最後提出三項重要方向:對高影響AI應盡可能從部署初期就納入隨機化評估;把評估機制直接納入AI治理,而非等到系統上線後才開始檢驗;同時也應公開沒有成功的研究結果,讓負面證據成為保護病人與改善下一輪設計的重要基礎。
AI快速演進也意味著持續監測不可或缺。模型部署後仍可能出現效能漂移、族群差異及非預期影響,因此醫療機構需要定期重新檢視模型表現,而不是將一次性的驗證視為永久有效的保證。
醫療AI真正成熟的標誌,或許不在於擁有多少模型,而在於醫療體系是否有能力持續判斷「什麼有效、什麼沒有效,以及為什麼」。
從AI治理、電子病歷整合、隨機臨床試驗,到真實世界證據,Allen L. Hsiao教授的分享指向同一個核心:準確的預測只是起點,能夠把預測轉化為適切的臨床行動,並經由真實世界驗證確認病人確實受益,才是醫療AI真正的價值所在。