【衛生福利部《2026臨床 AI 取證驗證中心國際研討會》系列文章2】
衛生福利部資訊處 李建璋 技監兼處長(演講者)
次世代數位醫療平台專案辦公室整理
醫療人工智慧(AI)從單一醫院開發走向實際應用,必須面對病人族群、疾病樣態及資料格式的差異。衛生福利部資訊處李建璋處長於四大臨床AI取證驗證中心年度交流中,回顧跨院驗證網絡的建置理念與推動進展,並說明第二階段的三項重點:深化醫療資料的語意標準化、以聯邦學習基礎建設支援臺灣主權AI,以及拓展跨國模型驗證合作。整體規劃以資料治理與隱私保護為基礎,協助醫療機構、產業及研究團隊運用更具代表性的資料,評估並改善醫療AI的適用性。
一、回應真實世界的疾病多樣性 建立跨院外部驗證機制
李處長以糖尿病視網膜病變辨識為例指出,若驗證資料僅區分為正常與患病兩類,可能無法充分反映真實臨床情境。病人的疾病嚴重度具有連續變化,也可能同時出現高血壓性視網膜病變等重疊病理;模型在相對單純資料中的高準確度,未必能維持於不同病人與醫療場域。
此外,單一醫學中心的資料難以涵蓋全國疾病及人口的多樣性。醫學中心與偏鄉、地區醫院的就醫族群有所不同,若模型開發與驗證未納入這些差異,其跨場域適用性便可能受限。為使醫療AI的評估兼顧不同地區與層級的病人,驗證中心須以醫院聯盟形式蒐集及整合資料。
李處長說明,建立具人口代表性的資料資源,對個別業者與研究團隊而言成本高、規模大,因此政府應投入共同基礎建設。四大臨床AI取證驗證中心的任務,即是提供跨院資料與專業驗證服務,協助開發者檢視模型移轉至不同醫療場域後的表現。
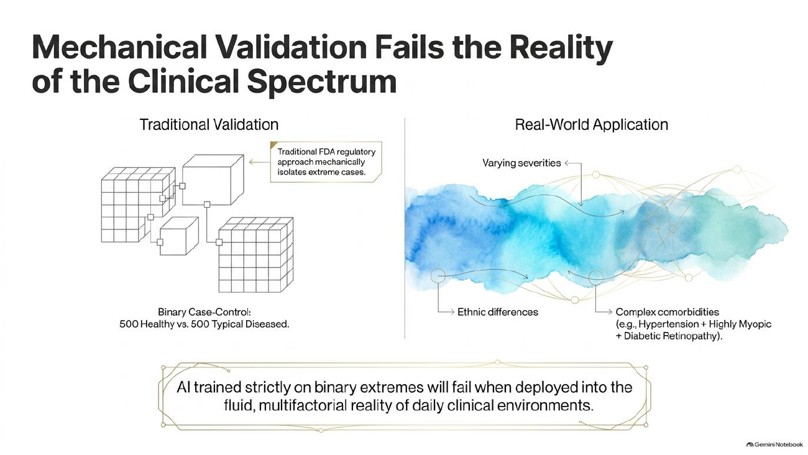
圖一、傳統二分式驗證與真實臨床疾病光譜的差異
二、克服全國資料應用的三項障礙 兼顧標準化與隱私
李處長指出,電子病歷與格式相對一致的健保申報資料不同。臺灣各院使用多種電子病歷系統,跨院整合首先須處理欄位、格式與內容的差異。第二項障礙是資料二次利用的授權與隱私,須規劃數位同意機制,讓民眾能動態選擇加入或退出。第三項則是研究環境:即使取得使用同意,也不代表研究者可任意將資料下載至個人電腦,仍需在受控環境中進行分析。
因此,國家級基礎建設的規劃包括以FHIR(Fast Healthcare Interoperability Resources)推動資料標準化、建立數位同意機制,以及建置可信研究環境(Trusted Research Environment, TRE)。在此架構逐步發展期間,先串聯已具備病歷資料庫、資料清理流程、倫理審查與院內分析環境的醫學中心,作為跨院驗證網絡的起點。
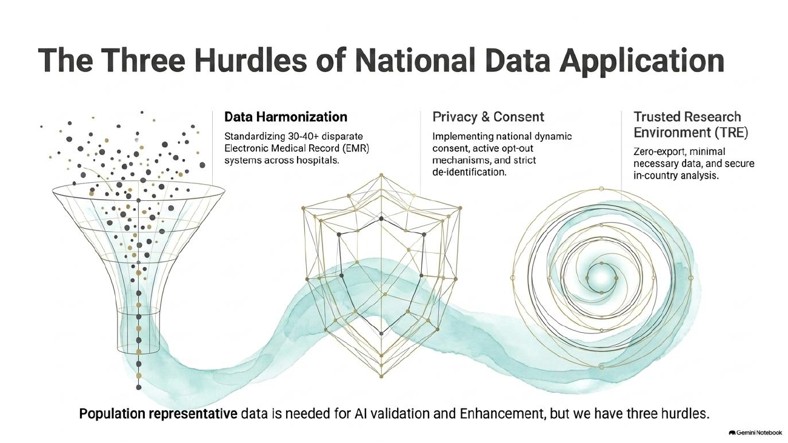
圖二、全國健康資料應用的三項障礙與治理重點
三、銜接TFDA諮詢與中心驗證 形成模型改善的閉環流程
李處長說明,開發者若希望將院內模型推向產品化,可先向衛生福利部食品藥物管理署(TFDA)尋求諮詢,了解預期用途、目標族群、驗證效能,以及性別比例與特定次族群等資料需求,再由驗證中心提出執行計畫與費用估算。中心收費係支應資料處理、行政及驗證作業,並非出售病人資料。
模型進入外部醫院後,效能可能下降,因此流程也納入調整與再驗證。李處長於演講中提及,中心可提供部分去識別化資料供模型微調,比例約為10%至15%,再完成驗證報告及取證申請。這項「諮詢、驗證、調整、回饋」的閉環設計,旨在協助開發者更有系統地準備審查資料;模型調整與取得許可仍是不同階段,不能將流程支援解讀為保證核准。
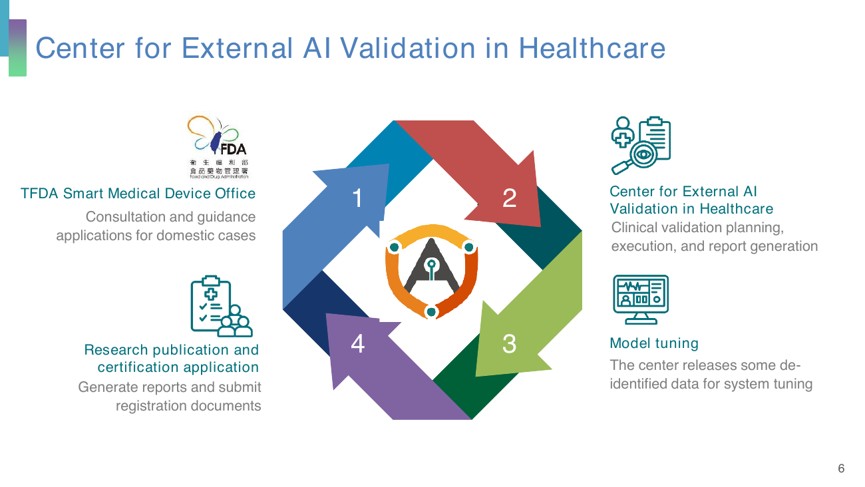
圖三、TFDA諮詢與臨床AI取證驗證中心的合作流程
四、四大中心串聯醫院聯盟 提供大規模跨院驗證資源
四大中心分別由三軍總醫院、亞東紀念醫院、高雄長庚紀念醫院及臺中榮民總醫院領銜,依演講說明已形成約16家醫院的網絡。簡報與演講介紹,中心已協助22家以上業者及醫療或學術機構,提供累計逾百萬筆不同類型的電子病歷資料資源,涵蓋影像、文字、結構化資料與波形,支持模型驗證與改進。
簡報列示的進行中案件,包括長庚心電圖死亡風險模型、亞東腹部CT氣腹分類、急性呼吸窘迫症候群(ARDS)分類及糖尿病視網膜病變影像判讀。其中,心電圖死亡風險模型的驗證樣本數列為573,924筆,腹部CT氣腹分類為38,260筆,呈現跨院網絡可提供的資料規模。各案同頁所列AUC、敏感度及特異度為預期驗證效能,並非已完成的實測結果。
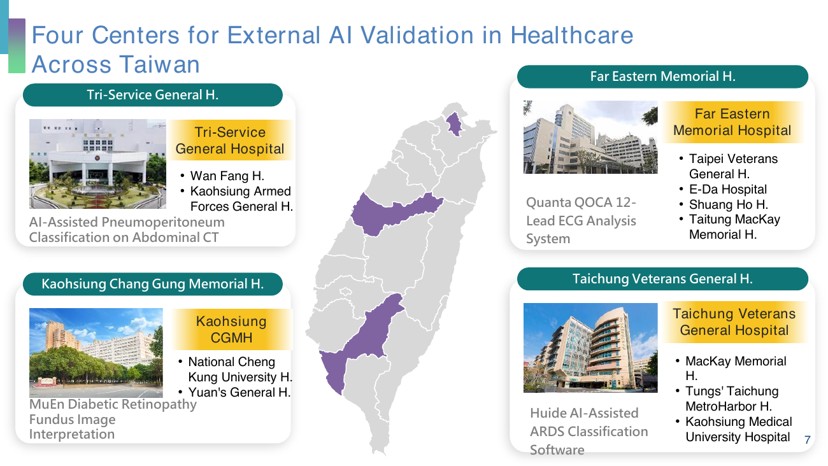
圖四、四大臨床AI取證驗證中心與合作醫院網絡
五、從FHIR格式整合走向語意標準化 提升資料細緻度
第一階段已要求各中心以FHIR整合聯盟醫院資料,並透過共同資料管理機制推動跨院協作。然而,格式一致不代表臨床內容的意義已完全一致,也不會自動增加資料的細緻度。李處長指出,若資料仍主要依賴ICD-10與健保代碼,許多病歷中的臨床細節仍難以充分用於研究。
第二階段因此規劃進一步導入SNOMED CT與LOINC等標準,將病歷敘述、診斷及檢驗資訊轉換為更一致、可檢索的臨床概念。藥品資料則配合既有健保代碼與RxNorm對應進度逐步處理。透過結構與語意兩個層次的標準化,跨院資料庫才能由「格式可串接」進一步走向「內容可理解與比較」。
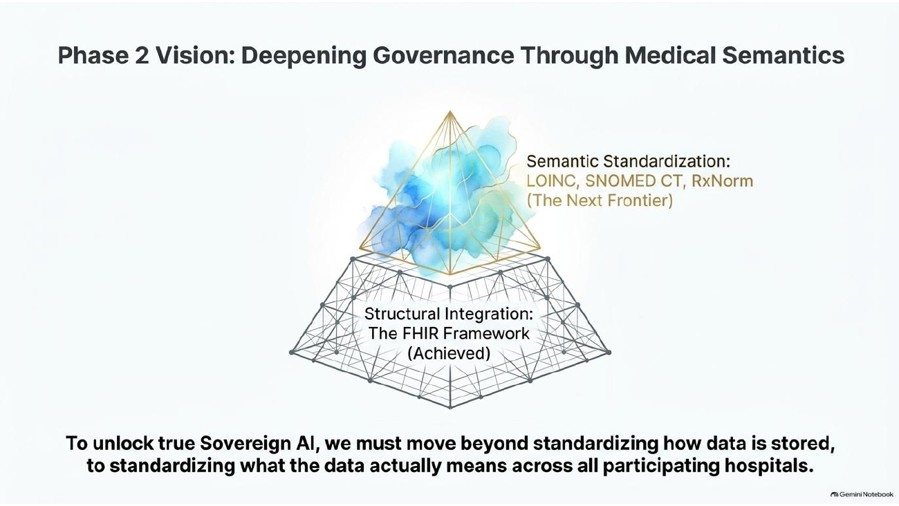
圖五、由FHIR結構整合深化至醫療語意標準化
六、導入智慧病歷編碼與人工複核 建立可檢索的研究資料庫
為協助資料轉換,李處長介紹雲端智慧電子病歷編碼工具(Smart EHR Coder)。臺灣病歷常混用中英文、縮寫與在地藥名,工具先輔助整理文字,再擷取醫療概念並對應SNOMED CT等標準。系統也呈現重複執行時的編碼一致性,供編碼人員判讀;最終結果仍須由人員複核,而非完全交由AI自行決定。
李處長期望各中心運用這些工具,建立更細緻的研究資料庫,並發展以臨床概念為核心的查詢介面。SNOMED CT的階層與概念關係可協助使用者尋找相關疾病及病人群體,例如由主動脈瓣狹窄延伸查詢相關概念,先確認潛在個案數與資料可用性,再規劃研究。這類可行性分析應結合可信研究環境,提升研究準備效率。
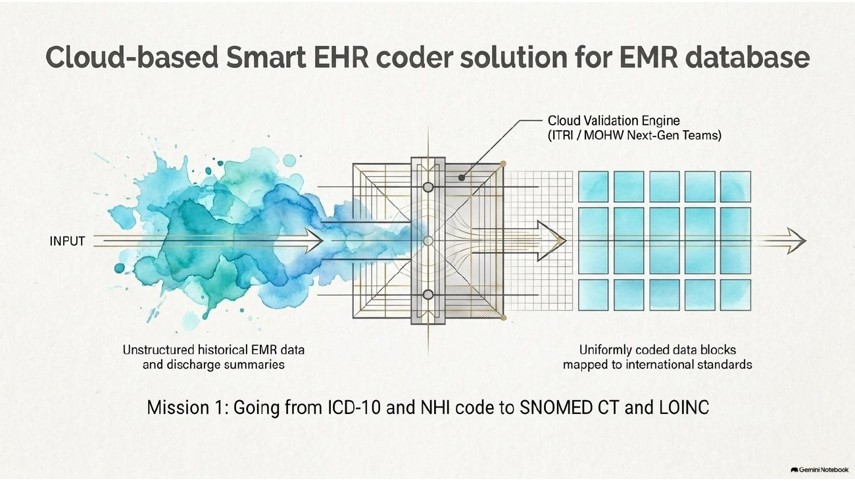
圖六、雲端智慧病歷編碼工具與資料標準化流程
七、以聯邦學習支援主權AI 發展臺灣多模態醫療基底模型
李處長指出,國際大型模型中的臺灣人口代表性仍有不足,因此主權AI的發展方向,是運用本土資料訓練或微調模型,使其更能反映臺灣的健康需求與臨床情境。四大驗證中心已建立的資料治理與聯邦學習平台,可作為後續共同開發模型的基礎。
演講提出三年發展構想,先由智慧病歷編碼工具著手,再推進多模態醫療基底模型。簡報所列資料模態包括胸部X光、乳房攝影、電腦斷層、病理影像、眼底影像、磁振造影、心電圖波形及生命徵象。李處長並表示,經由本次國際交流,規劃將由原先較集中於影像與文字的方向,擴展至更完整的多模態資料。
為支援此目標,演講提出將醫院網絡由約16家擴展至40至50家的構想,並另行推動資料蒐集計畫。各院在資料保留於本地的架構下參與聯邦訓練或微調,逐步建立適用於臺灣族群的模型。上述網絡規模與模型開發均屬後續規劃,並非已完成成果。
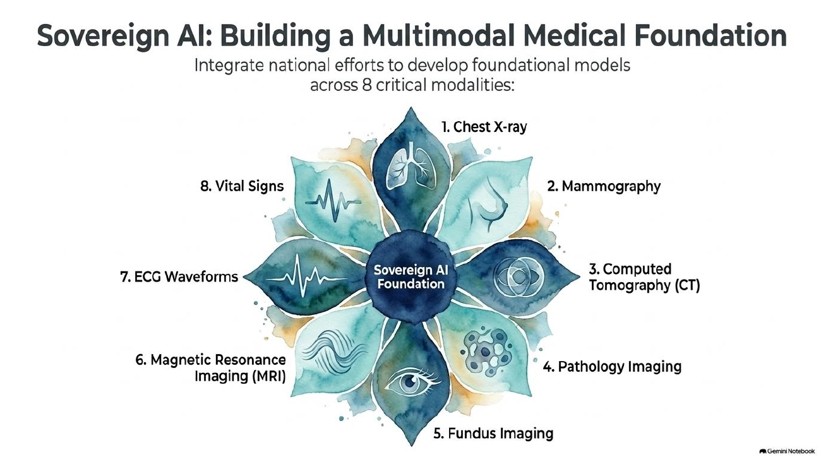
圖七、主權AI多模態醫療基底模型的資料範圍
八、推動資料不出境的跨國驗證 拓展國際合作
醫療資料具有高度敏感性,跨國合作須兼顧各地對資料使用與傳輸的要求。李處長說明,聯邦學習讓模型在不同機構間協作,而原始資料保留於當地,可作為跨境模型驗證的合作方式;對模型參數仍可能涉及的隱私風險,也提出以差分隱私(Differential Privacy)等技術進一步處理的方向。
演講介紹與泰國瑪希敦大學(Mahidol University)的合作,簡報列出四項聯邦驗證專案,涵蓋胸部X光多標籤分類與乳房攝影乳癌偵測,串聯臺灣醫院與泰國Ramathibodi Hospital。李處長期望以既有合作經驗為基礎,逐步拓展鄰近國家、歐洲及美國的合作機會,讓臺灣醫療AI在不同人口與醫療體系中接受驗證。
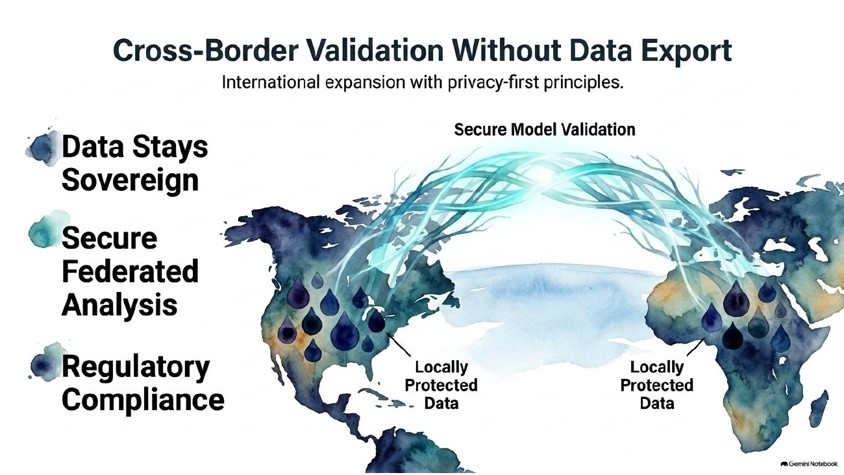
圖八、原始資料留於當地的跨境模型驗證架構
九、建立聯邦學習媒合平台 提供多元合作與智財安排
為協助研究團隊及業者尋找合作醫院,衛福部建置聯邦學習媒合平台,由提案者提出模型、研究需求與合作條件,供合適的醫療機構評估參與。李處長說明,涉及尚未公開的計畫時,參與機構須配合保密安排,並透過註冊及權限管理取得計畫資訊。
合作方式包括三類:以共同發表論文為目標的學術合作、依參與貢獻協議智慧財產權與商業化利益的共享模式,以及由業者支付驗證或協作所需費用的商業模式。提案者也可結合不同誘因,吸引醫院加入;具體權利、義務與費用安排則依各合作計畫協議。
平台除媒合外,也支援資格審查、雙方確認、需求討論與專案進度管理。李處長提出定期辦理媒合交流的規劃,並說明已有部分計畫取得醫院參與意向,期望將既有驗證網絡轉化為持續運作的跨院、跨國合作機制。
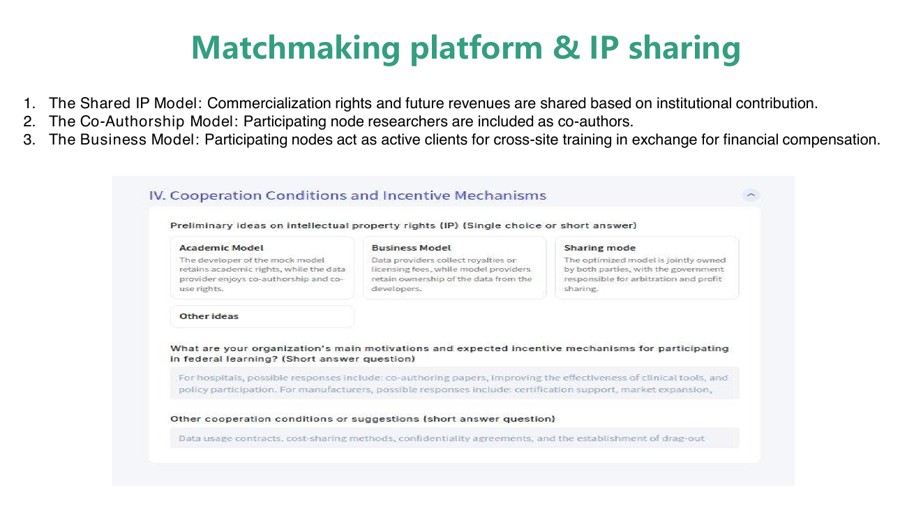
圖九、聯邦學習媒合平台的三種合作模式
十、綜合座談 完善資料治理並銜接臨床效益評估
針對全國資料應用,李處長說明「臺灣健康數據空間」採分散式、專案導向的設計構想。臨床照護與研究二次利用的授權應予區分,研究使用則以去識別化、公共利益及可信研究環境為前提,依核准專案與民眾同意情形運用資料,並規劃於專案結束後刪除該專案資料,而非將所有醫院病歷永久集中於單一資料庫。對於跨院倫理審查,也提出研議共同知情同意範本,以減少不同機構間的溝通落差。
與會者進一步指出,模型取得許可與預測表現良好,未必代表能改善病人存活或降低醫療成本。李處長回應,另有五家AI影響性研究中心協助評估臨床效益,並以研究證據支持給付優先順序的研議。考量隨機試驗所需時間,也希望探索具嚴謹流行病學設計的導入前後比較研究,在控制偏差的前提下加速累積臨床實用性資料。
對於合成資料,李處長提及現有Synthea模擬病人工具,並期望未來利用臺灣健康數據空間,發展更能反映本土人口特性的合成資料與代理人形式的模擬患者,作為研發及測試方向。此部分仍屬前瞻構想。整體而言,第二階段將由院內資料治理向外延伸,串聯全國主權AI建設與國際驗證合作,並與臨床效益研究相互銜接。
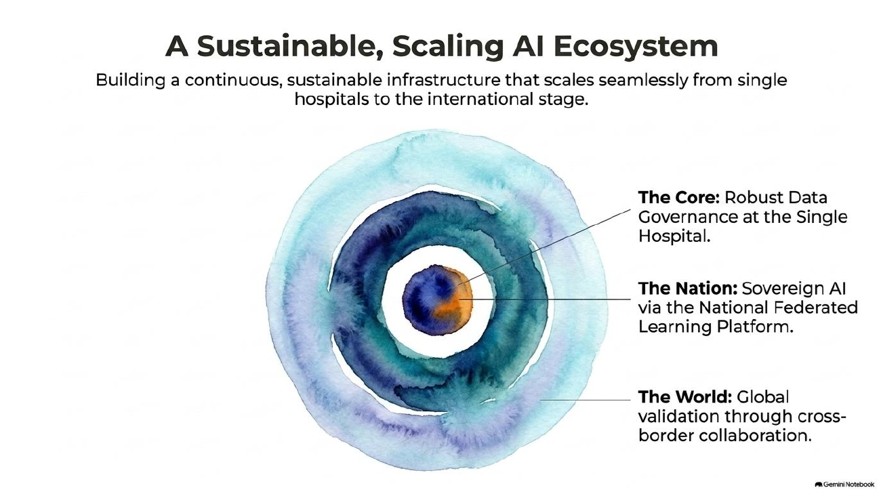
圖十、從院內資料治理到國家主權AI與國際驗證的發展架構